Publications

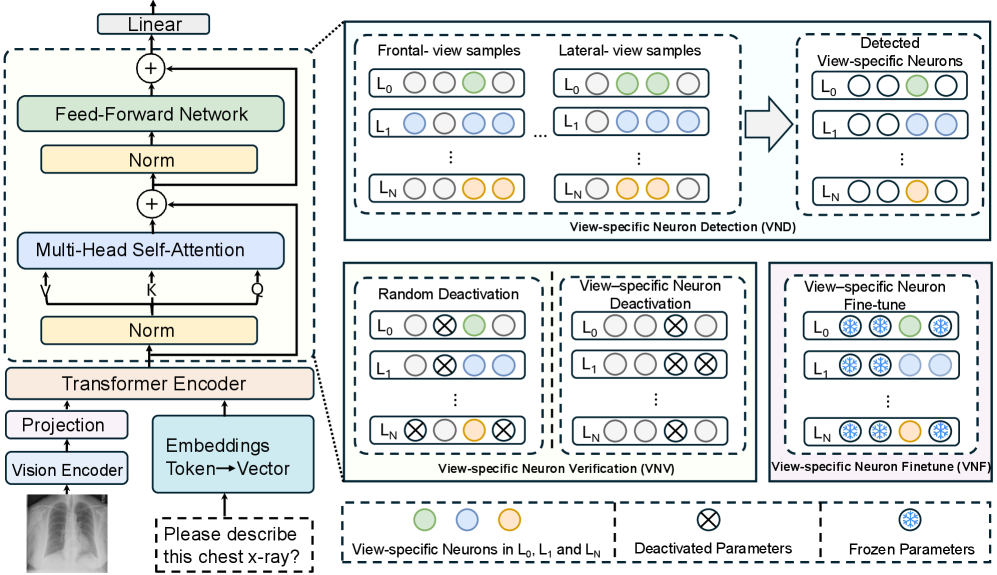
Seeing Through Multiple Views: Parameter-Efficient Fine-Tuning via Selective Neurons for Consistent Radiology Report Generation

Yucheng Chen, Jinjing Zhu, Yang Yu, Yufei Shi, Hane Naghshbandi, Jinhua Liu, Angela S. Koh, Fang Fen, Kian Eng Ong, Si Yong Yeo

MICCAI, 2026

A parameter-efficient framework that detects and selectively fine-tunes view-specific neurons to improve consistency in multi-view radiology report generation.
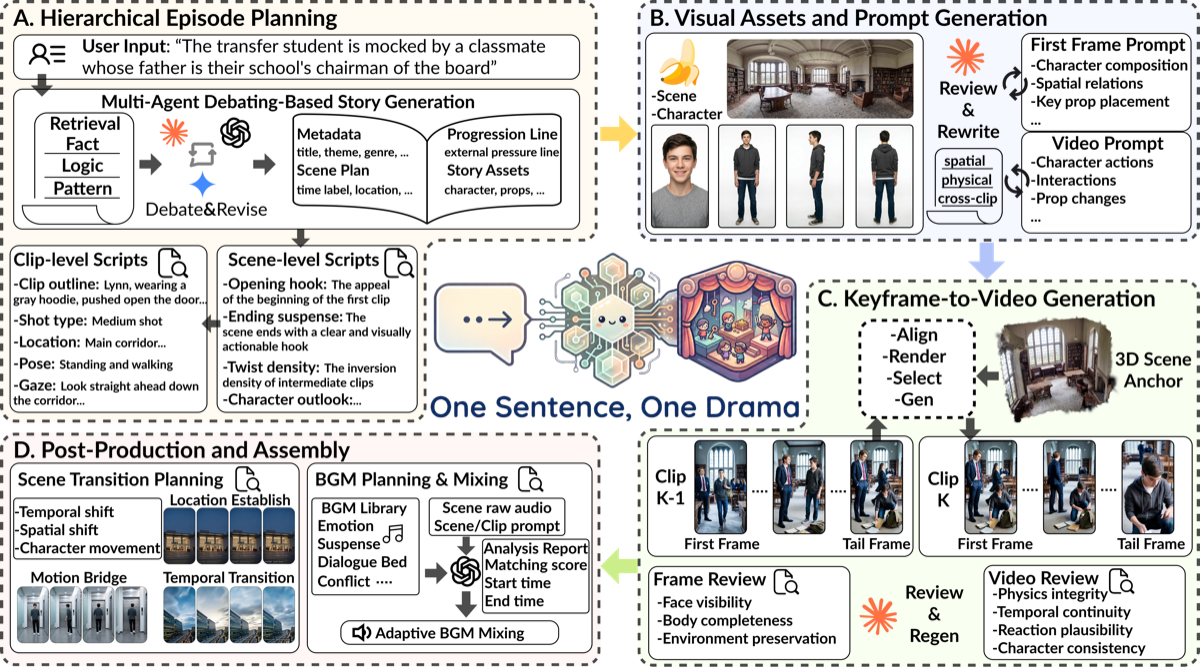
One Sentence, One Drama: Personalized Short-Form Drama Generation via Multi-Agent Systems

Yufei Shi*, Weilong Yan*, Naixuan Huang, Yucheng Chen, Chenyu Zhang, Tao He, Si Yong Yeo, Ming Li

Under Review, 2026

A multi-agent system for single-sentence to short-drama generation with pacing, narrative coherence, and 3D consistency.

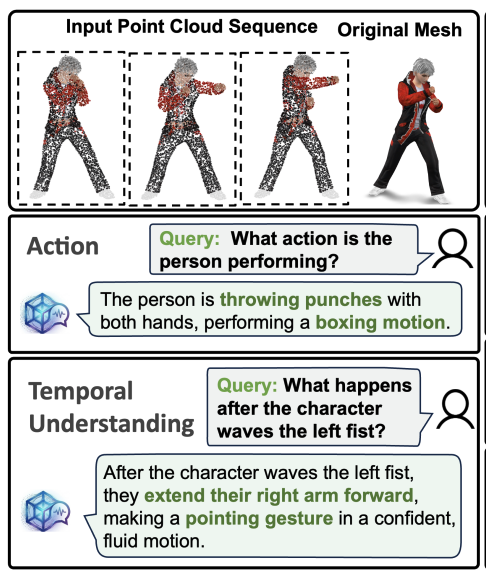
4DPC^2hat: Towards Dynamic Point Cloud Understanding with Failure-Aware Bootstrapping

Xindan Zhang, Weilong Yan, Yufei Shi, Xuerui Qiu, Tao He, Ying Li, Ming Li, Hehe Fan

ICML, 2026

A failure-aware framework that helps multimodal large language models understand dynamic point cloud sequences.

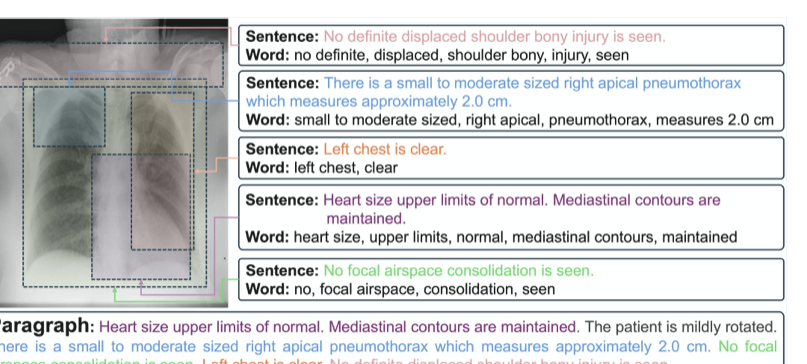
RIHA: Report-Image Hierarchical Alignment for Radiology Report Generation

Yucheng Chen, Yang Yu, Yufei Shi, Conghao Xiong, Xulei Yang, Si Yong Yeo

IEEE JBHI, 2026

A hierarchical alignment framework for radiology report generation that aligns visual and textual features across paragraph, sentence, and word levels.

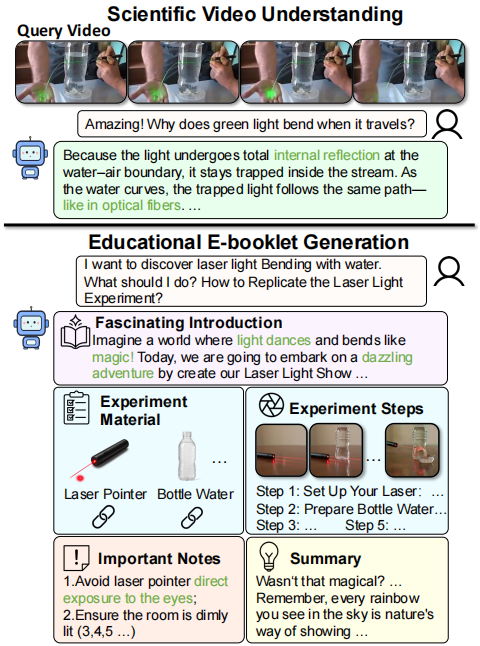
SciEducator: Scientific Video Understanding and Educating via Deming-Cycle Multi-Agent System

Zhiyu Xu, Weilong Yan, Yufei Shi, Xin Meng, Tao He, Huiping Zhuang, Ming Li, Hehe Fan

CVPR, 2026

The first multi-agent system for scientific video understanding and education.

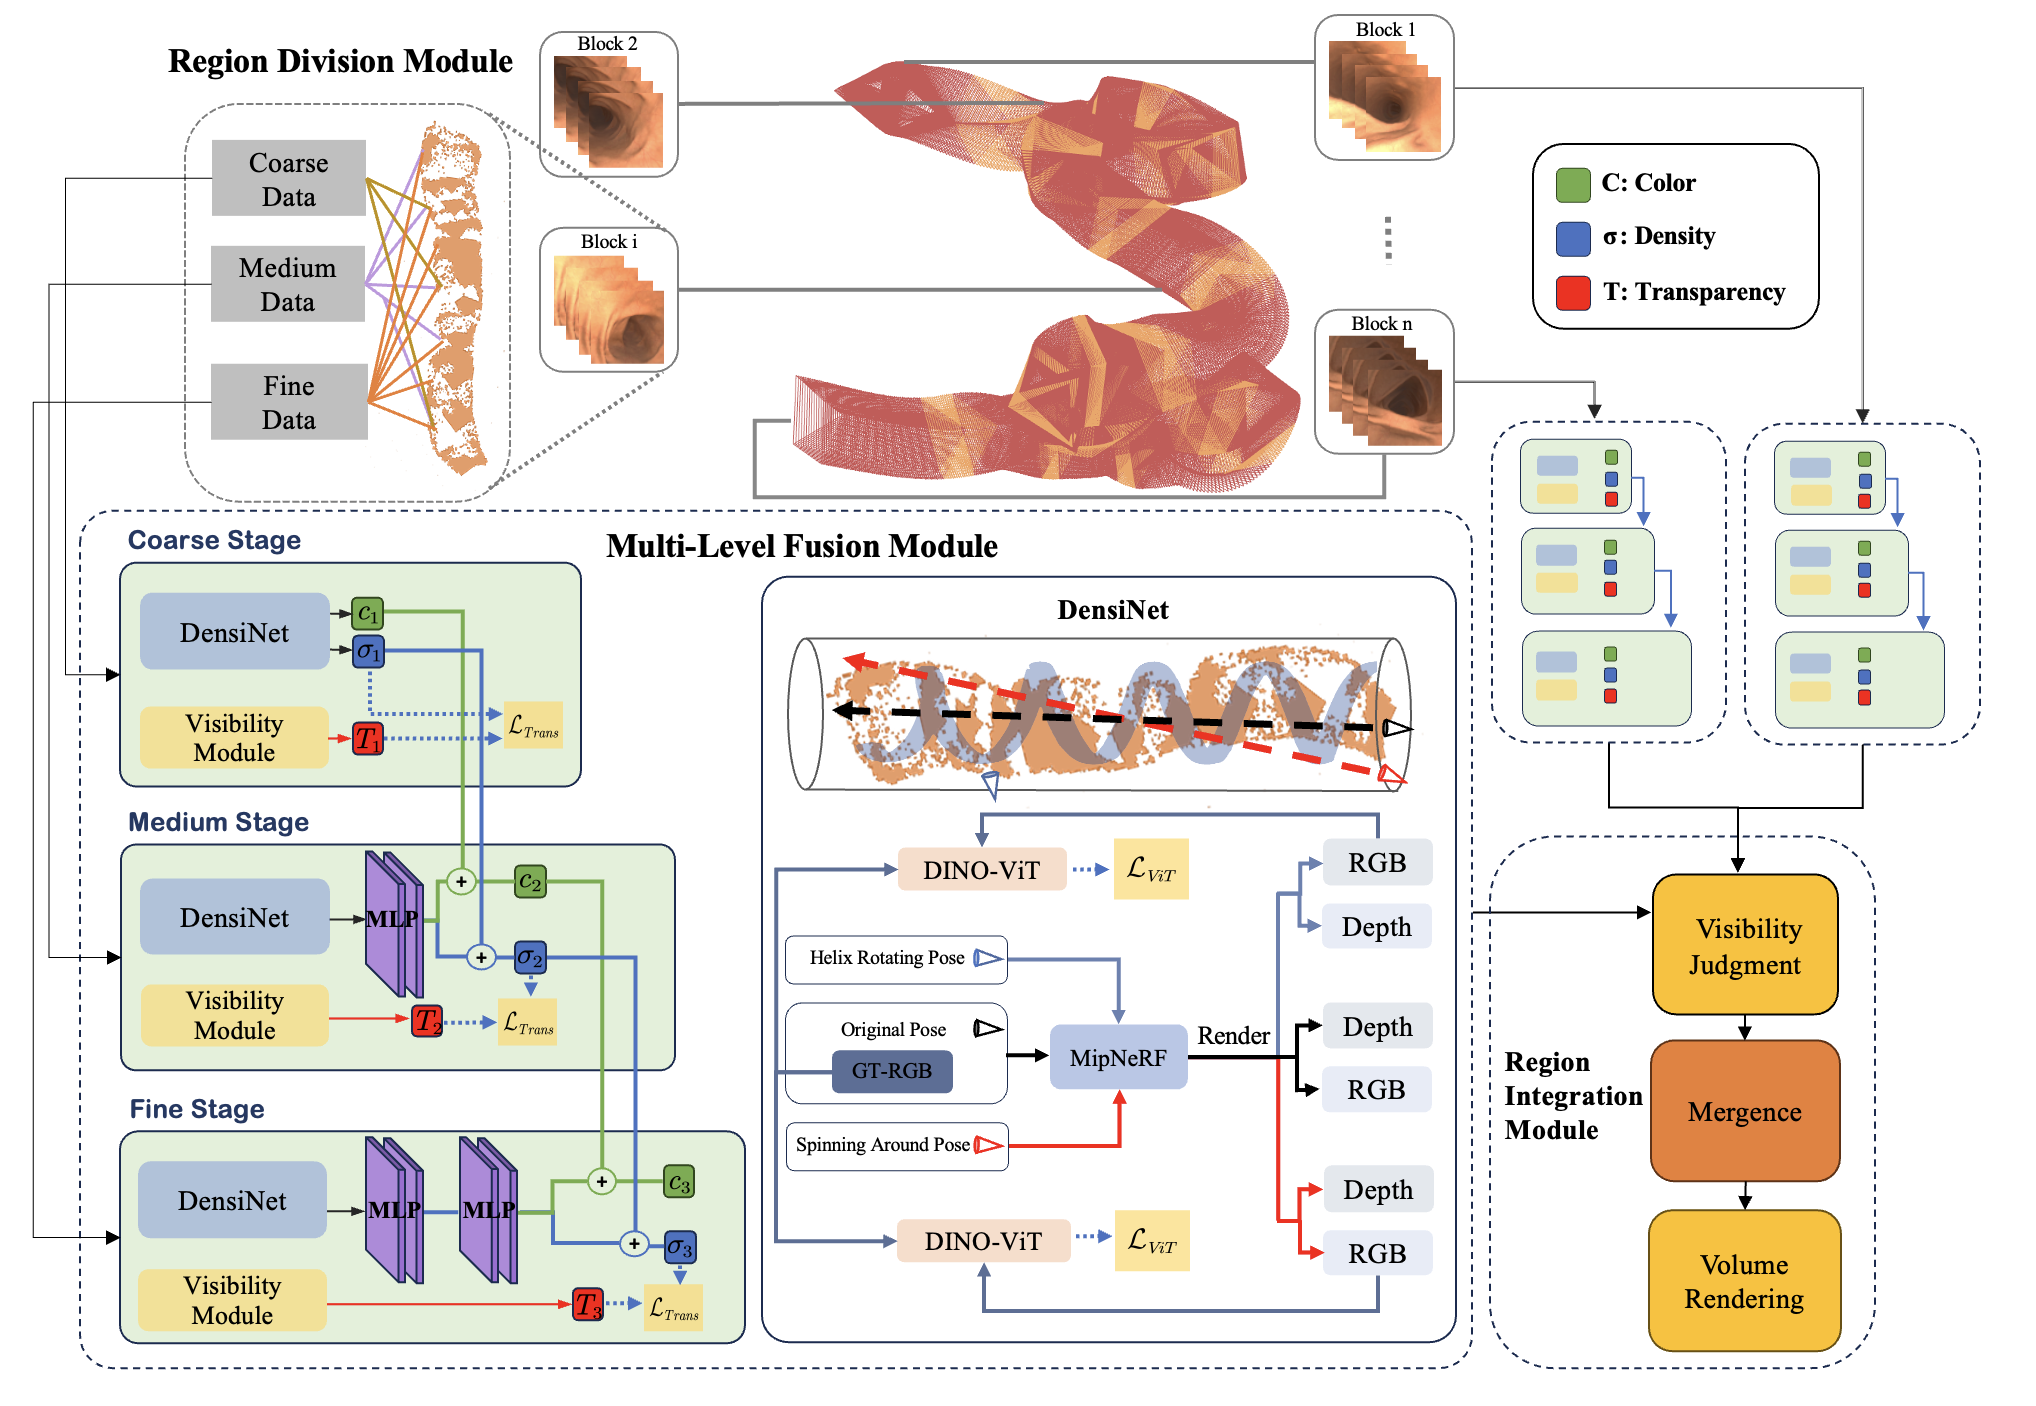
ColonNeRF: Neural Radiance Fields for High-Fidelity Long-Sequence Colonoscopy Reconstruction

Yufei Shi, Beijia Lu, Jia-Wei Liu, Ming Li, Si Yong Yeo, and Mike Zheng Shou

Neurocomputing, 2025

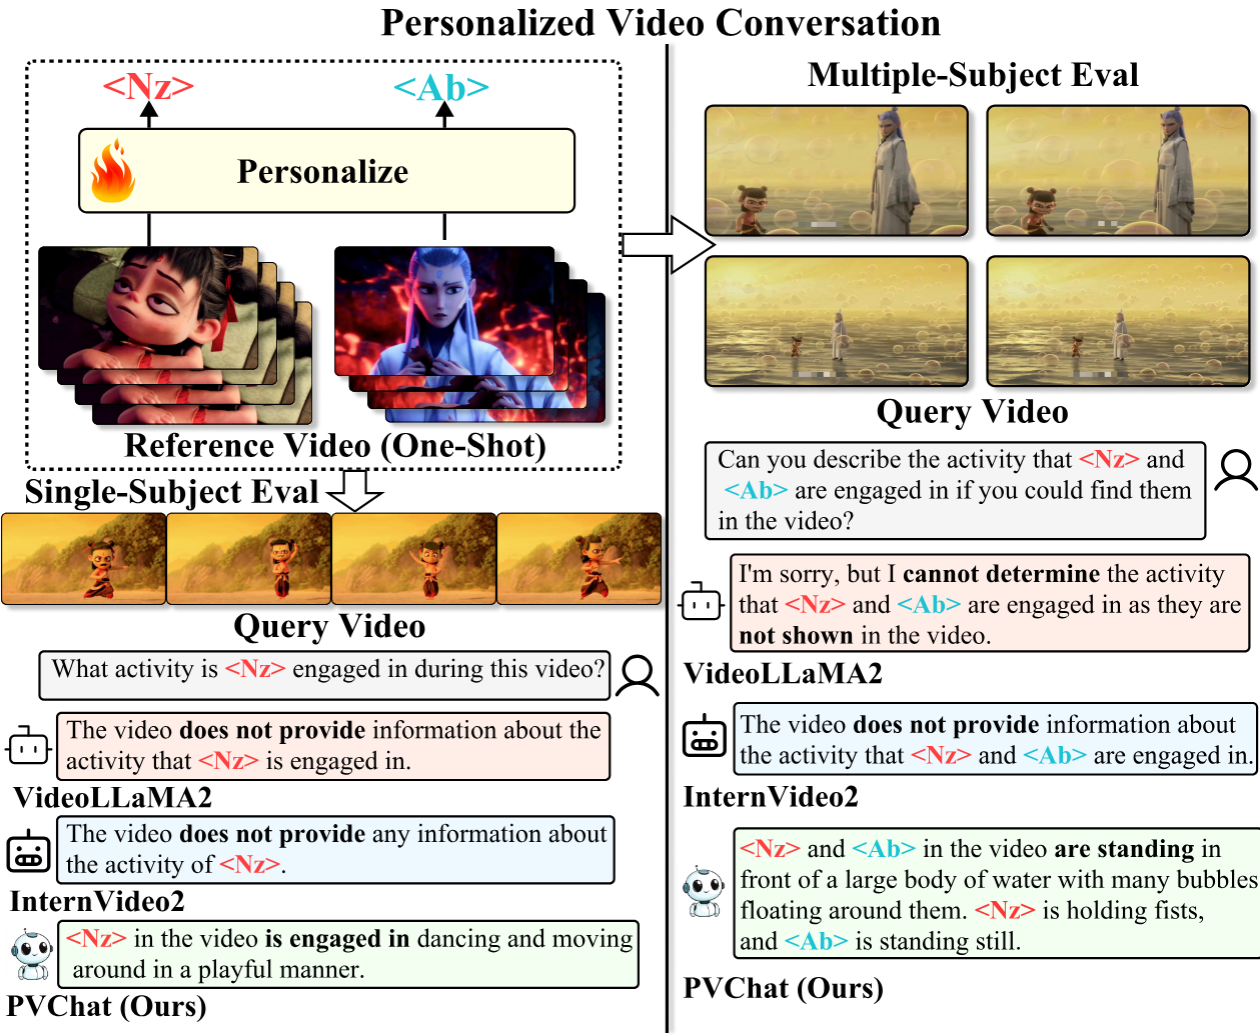
PVChat: Personalized Video Chat with One-Shot Learning

Yufei Shi†, Weilong Yan†, Gang Xu, Yumeng Li, Yucheng Chen, Zhenxi Li, Fei Richard Yu, Ming Li*, Si Yong Yeo*

ICCV, 2025

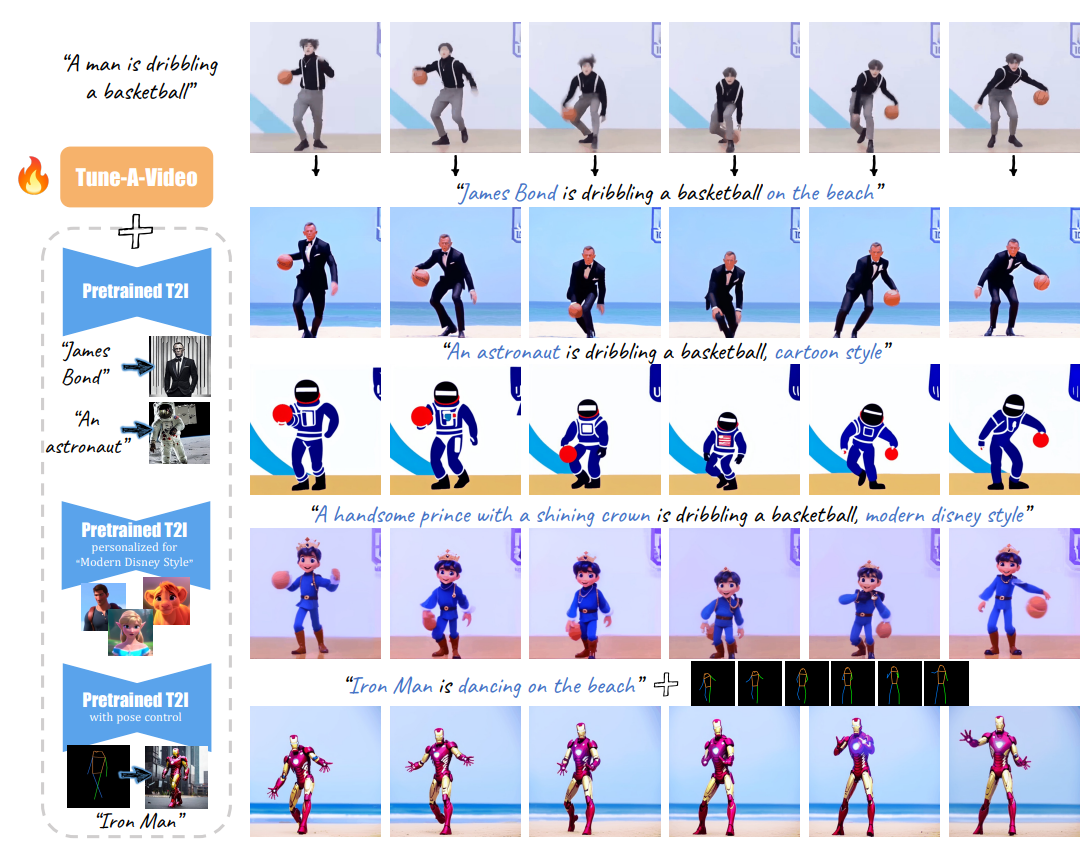
Tune-A-Video: One-Shot Tuning of Image Diffusion Models for Text-to-Video Generation

Jay Zhangjie Wu, Yixiao Ge, Xintao Wang, Weixian Lei, Yuchao Gu, Yufei Shi, Wynne Hsu, Ying Shan, Xiaohu Qie, Mike Zheng Shou

ICCV, 2023